01
共同背景与职责
在蓝色光标实习期间,我按照导师的要求参考海外 AI 视频模板,独立搭建了宠物播客和宠物采访两套工作流。两者都需要组织角色画面、脚本、配音和视频,但内容形式与调试重点不同。
- 宠物播客
- 两只宠物围绕话题对话,重点是音色筛选与片段时长。
- 宠物采访
- 根据照片与描述形成采访内容,重点是角色描述与台词时长。
02 / 独立工作流
宠物播客
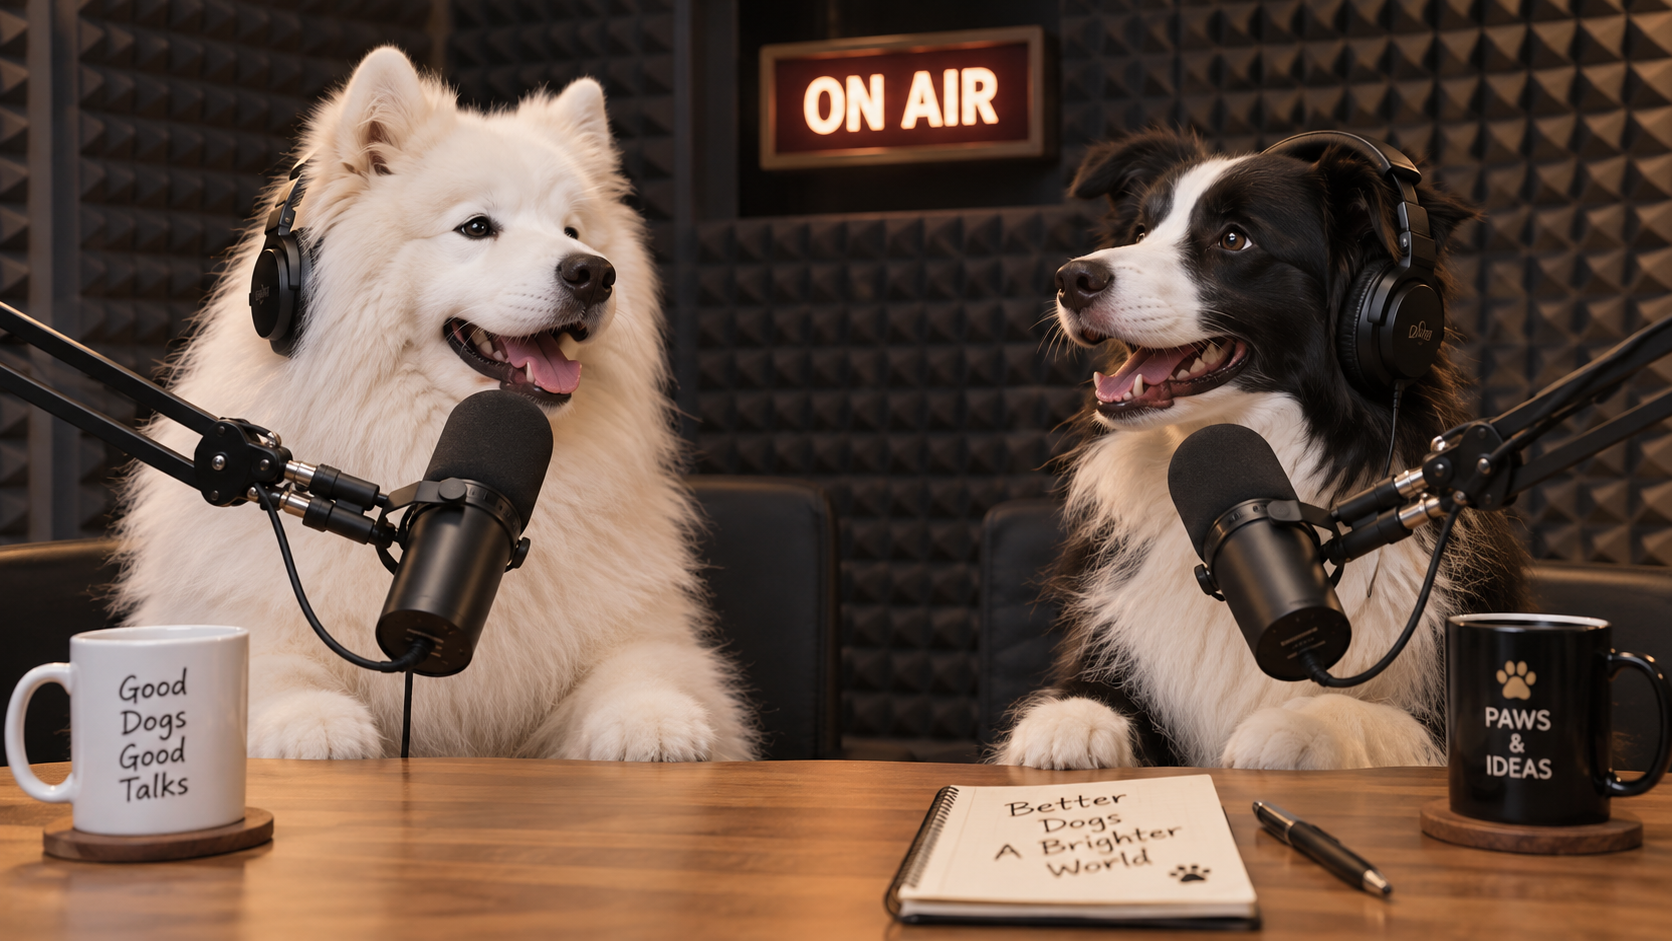 观看宠物播客成品
目标与流程
宠物播客的目标是让两只宠物成为对话角色,根据上传的照片和话题生成一段播客式短视频。工作流需要组织对话脚本、角色画面、配音和剪辑,让这些部分衔接起来。
工作流从宠物照片和话题开始,生成对话脚本与分镜画面,再准备 TTS 配音和视频片段,最后组合视频、声音与字幕。
声音怎么选、每段话占多长时间,会直接影响观看体验。我把主要调试精力放在这两个问题上。
先试听,再限定音色范围
音色是我当时最难处理的问题之一。让工作流自己寻找它认为合适的声音,很难表达我对“好听”的具体判断。
我逐个试听 TTS 库里的声音,把自己认为合适的音色整理成预选库,再要求工作流只能从这些音色中选择。
这个调整把选音分成两步:先由我完成试听与筛选,再由工作流在给定范围内选择。人工判断因此成为流程中的一个明确约束。
把生成时长和成片时长分开
另一个问题是,口播和动物嘴部动作的时间对不上。
当时使用的视频生成工具至少生成 5 秒片段,但每句台词需要的时间不同。我先通过脚本字数控制台词长度,再生成 5 秒视频,在后期把片段裁剪到所需长度。
最终保留的镜头时长可以跟随口播调整。这个方案针对口播与画面的时长、节奏匹配;它本身不等于逐个发音的精准嘴型同步。
03 / 独立工作流
宠物采访
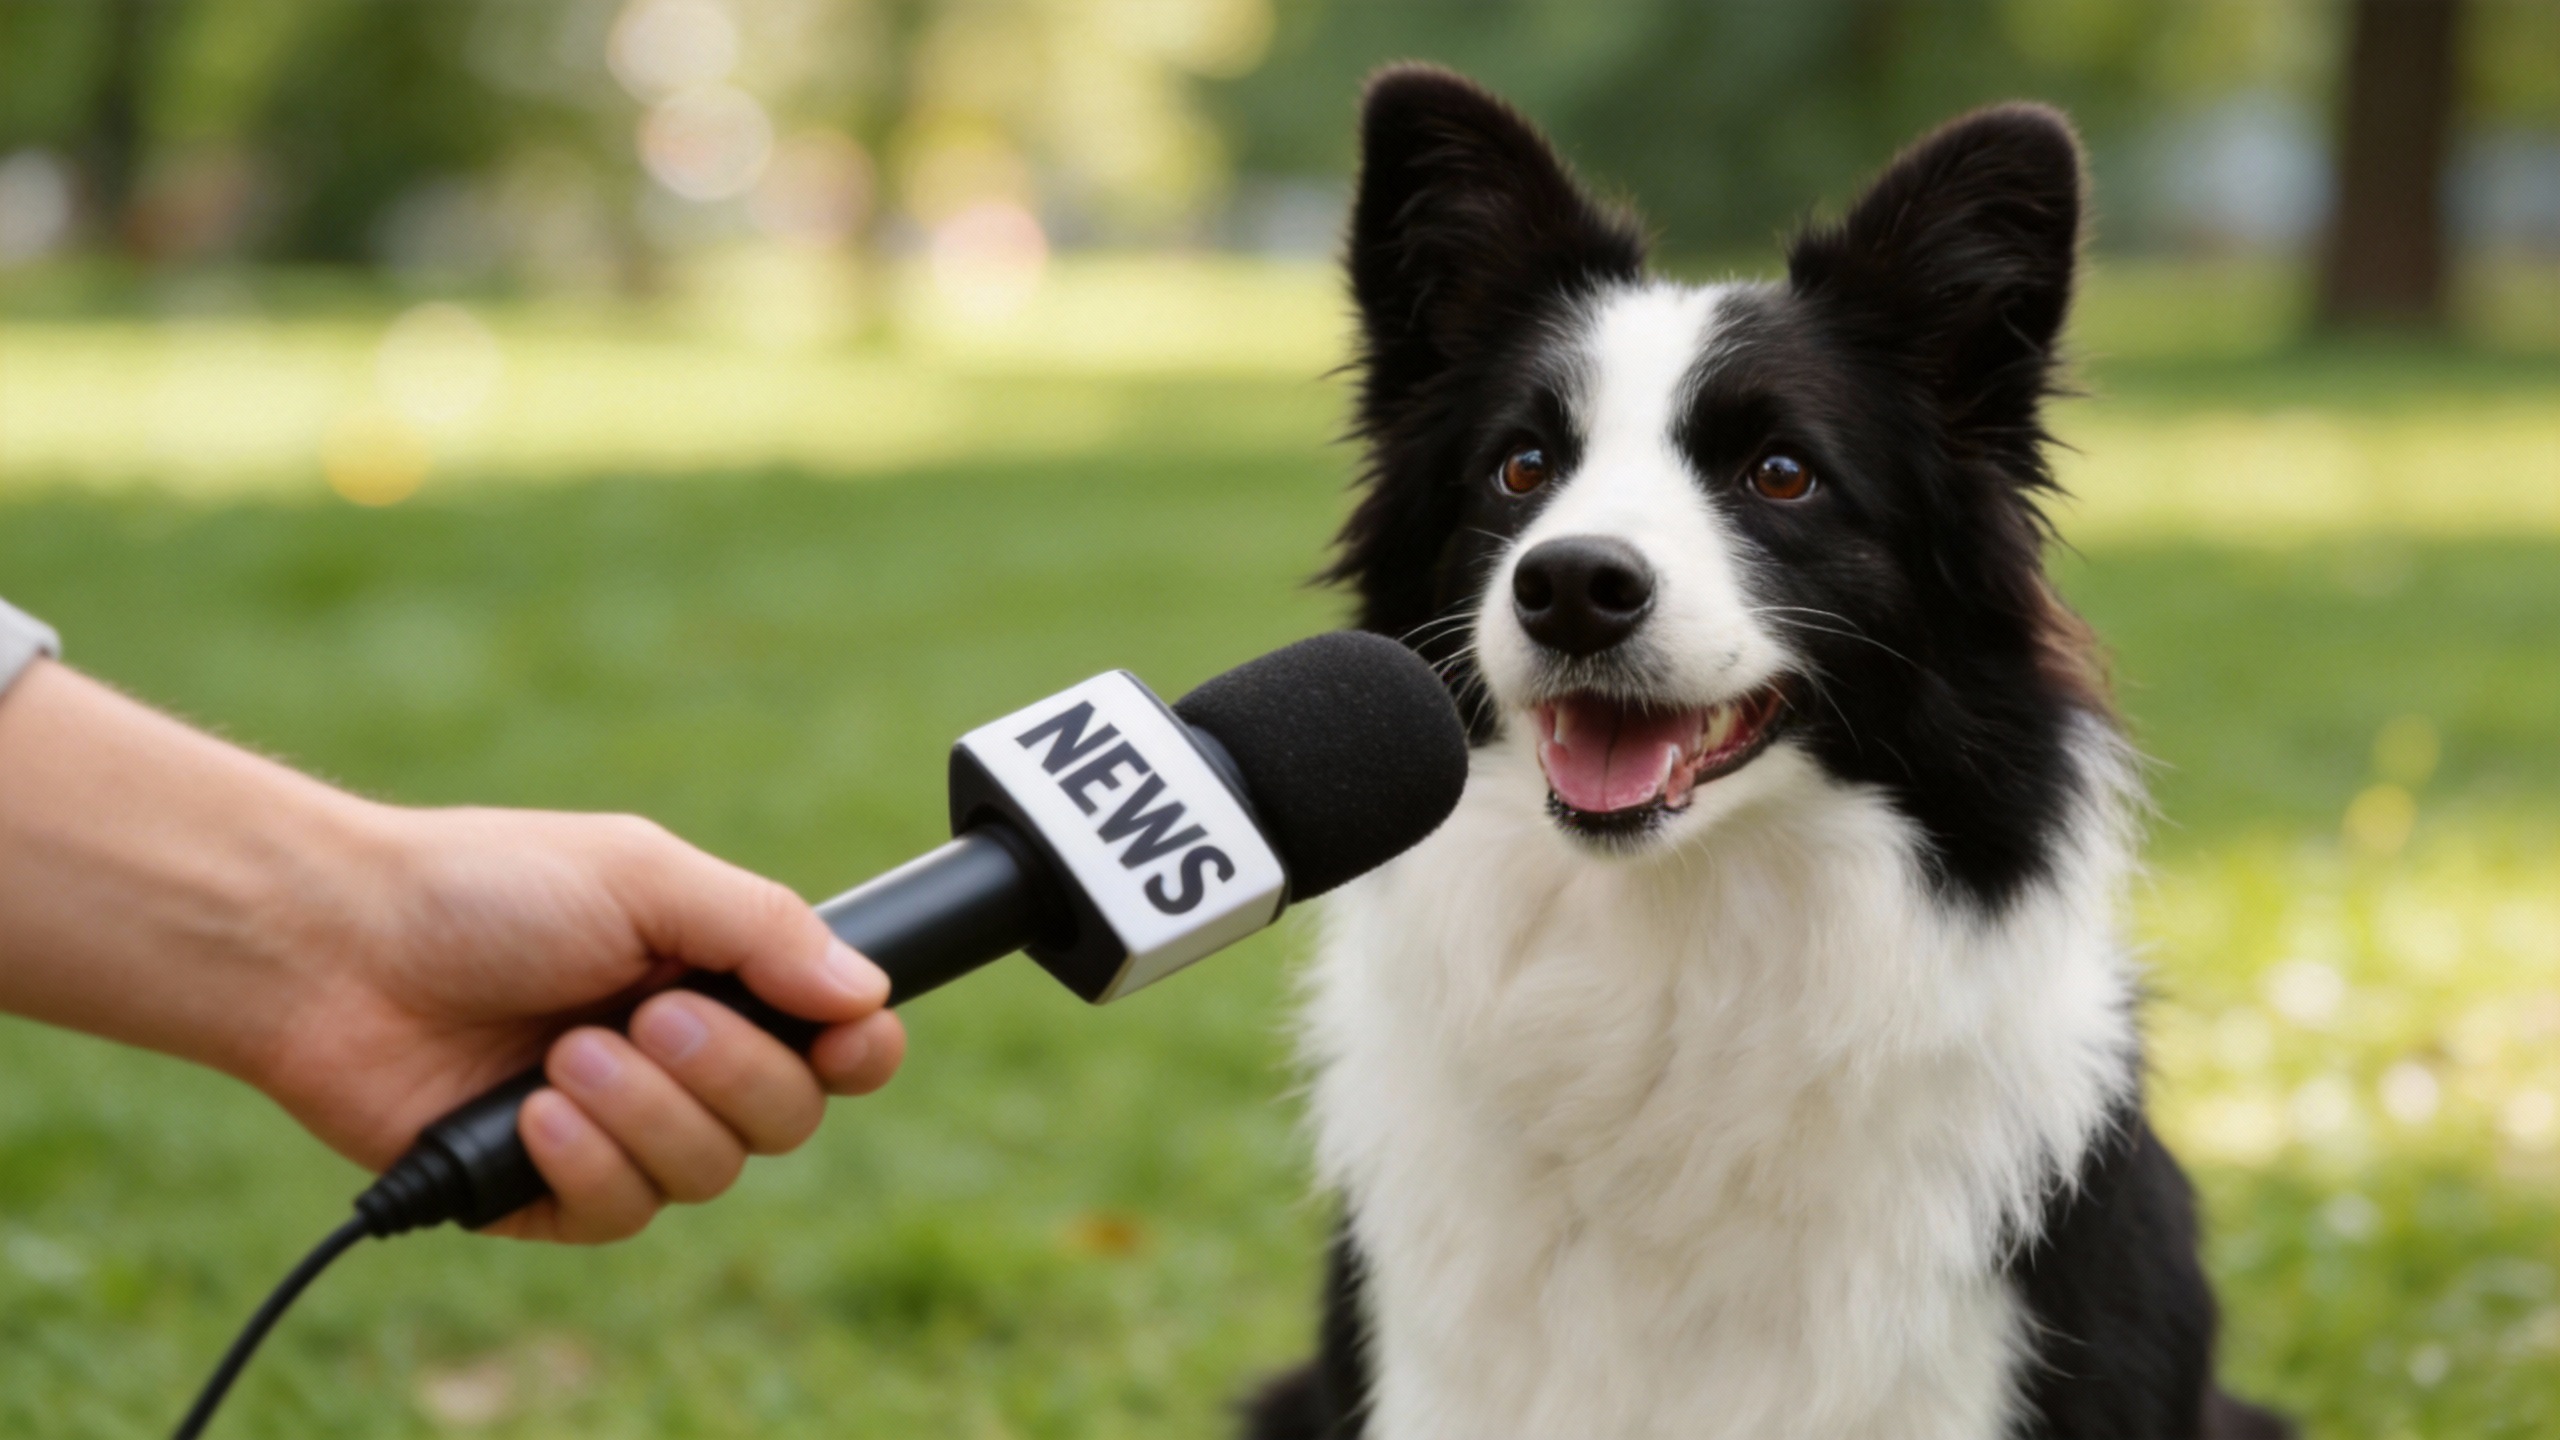 观看宠物采访成品
目标与流程
宠物采访是另一套参考模板独立搭建的工作流。用户上传两张宠物照片,并可补充简短描述,生成带有角色个性和配音的采访视频。
照片与描述 → 角色特征提取 → 采访脚本 → 配音与分镜时长检查 → 视频与字幕合成。
提取角色特征
我要求模型逐项提取动物特征,形成标准化视觉描述,为不同镜头中的角色形象提供统一参考。
比较时长,调整台词
采访工作流中设置了配音时长与分镜时长的比较,并通过精简台词和再次检查来调整时长。这与播客中生成 5 秒片段后裁剪的处理方式分开呈现;时长匹配不等于精准嘴型同步。
04
交付与共同收获
我独立完成了两套模板工作流。团队完成效果后交由后端部署网站,我负责工作流搭建与内容效果,不承担后端部署。
回看这次开发,我会把它理解为一次将目标效果转化为具体约束的实践:音色需要人工试听和筛选,片段时长需要考虑台词与生成工具的限制。
后续如果继续迭代,我会分别检查音色选择、片段时长和嘴部动作的匹配情况,让每个问题都有明确的观察对象。
后续希望探索多语种支持,让同一类模板适配更多语言内容。
返回作品集